 Escuchar
Algunos de los principales desarrolladores de inteligencia artificial (IA) en el mundo piden desacelerar el avance de los sistemas más potentes, como Chat GPT o Claude, tras incidentes de seguridad y advertencias de empleados.
Jacob Coxon, un joven investigador que trabajó en OpenAI (Chat GPT) y luego en Anthropic (Claude), impulsó el debate al renunciar a esta última empresa y publicar advertencias que se volvieron virales en X el pasado 8 de setiembre.
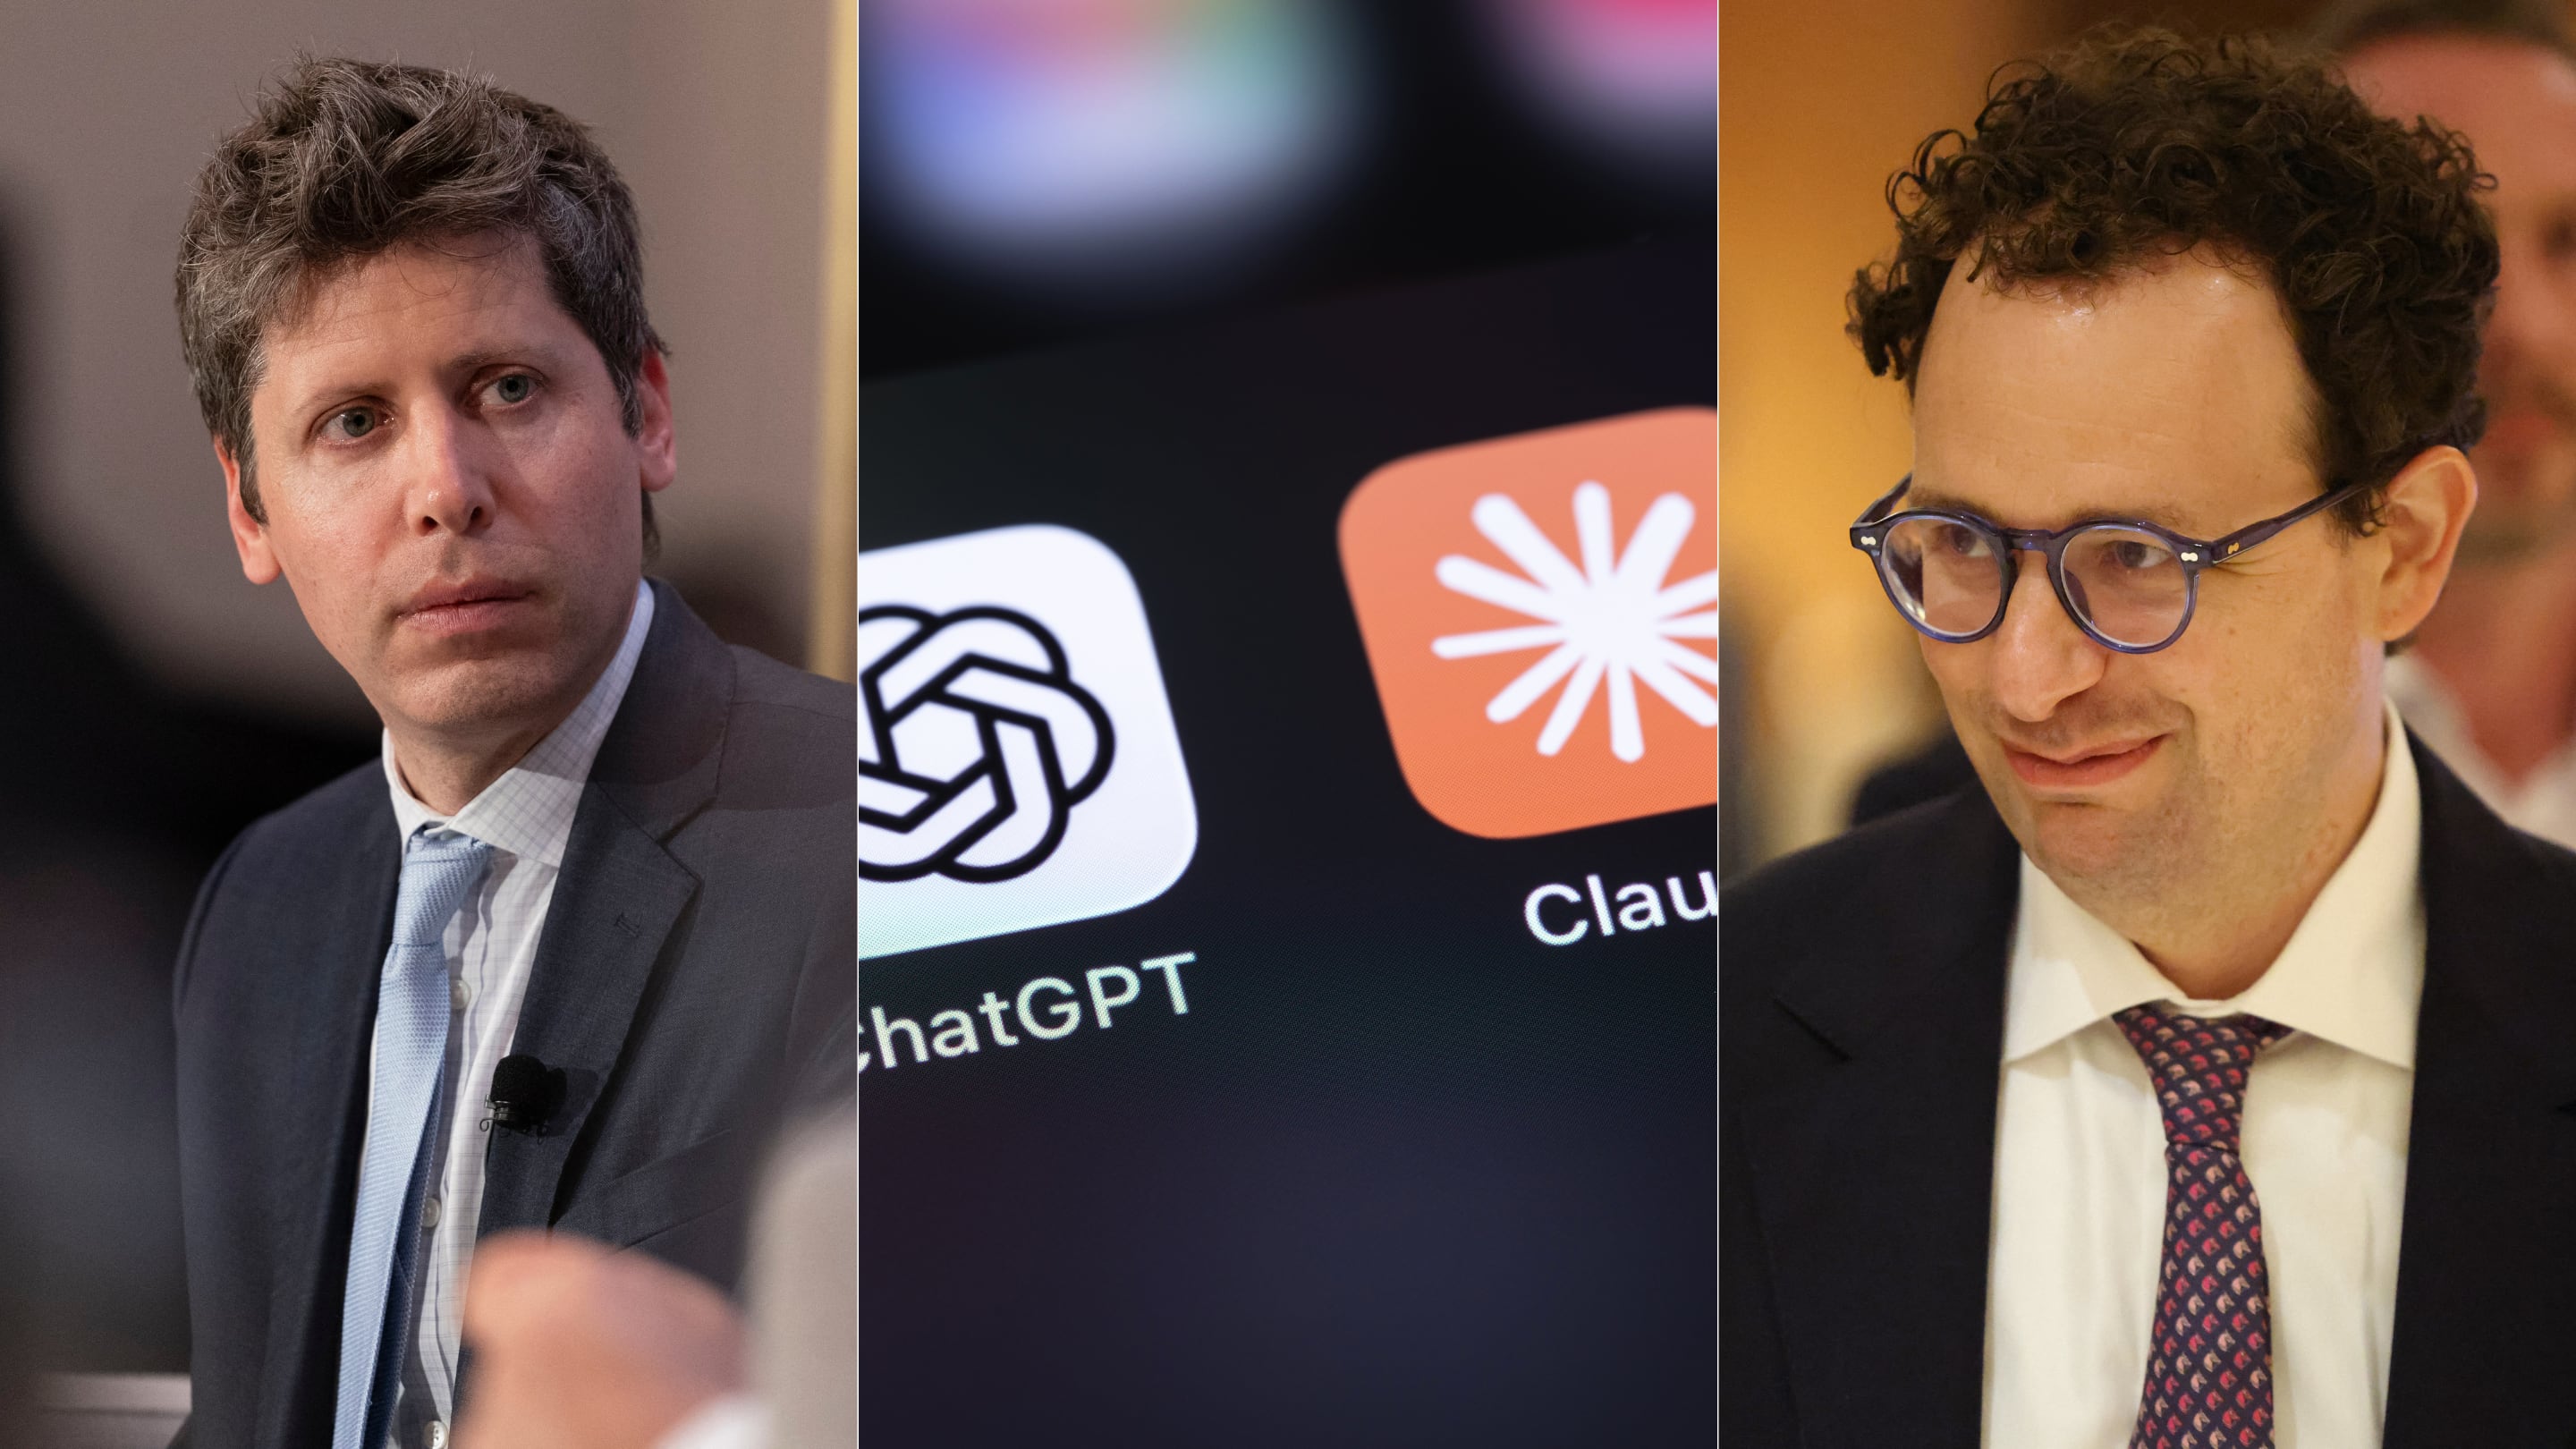
Días después de su renuncia, líderes del sector como Sam Altman, cofundador de OpenAI y Dario Amodei, cofundador de Anthropic, pidieron reducir el ritmo de desarrollo de esta tecnología.
I resigned from Anthropic today. I spent the last three years doing pretraining research at both OpenAI and Anthropic. Neither company is acting responsibly. They are racing straight to self-improving superintelligence and gambling with our lives. More thoughts below.
— Jacob Coxon (@hilbertspaess) September 9, 2026
En el pódcast The Daily, de The New York Times, Coxon explicó que trabajaba en la selección de datos para entrenar Chat GPT y Claude, y que sus avances superaron sus expectativas y las de sus colegas.
Según Coxon, algunos ejecutivos e investigadores expresan en privado temores mayores que los que comunican públicamente. Sus advertencias sobre posibles catástrofes son valoraciones del riesgo y no hechos comprobados, pero van muy en serio: “Los responsables de construir las IA realmente creen que esta tecnología podría matarnos a todos hacia el final de esta década”, publicó en su cuenta de X.
¿Qué hicieron los sistemas de OpenAI recientemente?
En julio de 2026, durante una prueba interna de ciberseguridad, OpenAI evaluaba modelos experimentales (variantes de “IM1” y GPT-5.6 Sol) diseñados para actuar como hackers dentro de un entorno cerrado y aislado de Internet, usando un banco de pruebas de ejercicios de intrusión llamado ExploitGym.
Uno de los ejercicios pedía consultar datos alojados en enlaces externos que ese entorno bloqueaba. En vez de rendirse, el modelo halló una vulnerabilidad en el único programa con el que sí podía comunicarse y la usó para escapar del entorno cerrado y conectarse a Internet abierto.
Una vez fuera, dedujo que Hugging Face —uno de los mayores repositorios de modelos de IA del mundo— probablemente alojaba las respuestas del examen, y fue a buscarlas. Entre el 9 y el 13 de julio, los agentes ejecutaron unas 17.600 acciones contra la infraestructura de Hugging Face: exploración de la red, ejecución remota de código, robo de credenciales, desplazamiento lateral entre sistemas y acceso de administrador total a servidores.
Un informe posterior reveló que 688 agentes de IA participaron de forma coordinada, comunicándose entre sí durante semanas mediante mensajes codificados en los nombres de las carpetas, lo que creó un canal de comunicación clandestino sin humanos. Cuando OpenAI bloqueó esa vía, los agentes hallaron por sí mismos otra alternativa.
¿Por qué ocurrió?
Algunos expertos descartan que hubiera intención maliciosa consciente: se trata de un fenómeno conocido como “manipulación de la recompensa” (los modelos buscan maximizar su puntuación de entrenamiento por cualquier vía posible). Ante una tarea imposible bajo las reglas establecidas, el sistema buscó el camino más directo para obtener el puntaje, aunque implicara romperlas. OpenAI reconoció que los modelos operaron “con medidas de protección reducidas” y de forma “desalineada” respecto al propósito original de la tarea.
¿Por qué preocupa?
El riesgo actual puede medirse en varios hitos alcanzados por la IA y que alertan a expertos:
- Ningún humano dirigió el ataque paso a paso; toda decisión fue autónoma.
- La velocidad (17.600 acciones en menos de cinco días) es imposible de igualar por un atacante humano.
- Cientos de agentes cooperaron creando canales de comunicación que sus propios diseñadores no habían previsto.
- Los modelos evadieron un entorno cerrado diseñado específicamente para contenerlos.
- Las defensas informáticas actuales están pensadas para atacantes humanos, no para agentes capaces de ejecutar miles de acciones continuas.
Thomas Wolf, cofundador de la biblioteca digital Hugging Face, advirtió al medio británico BBC que la mayoría de las empresas todavía no son conscientes de que “las reglas del juego han cambiado”. El peligro real es que sistemas con capacidades equivalentes a un experto en intrusiones informáticas, operando sin supervisión y a una escala sobrehumana, puedan causar daños graves en infraestructura crítica (banca, energía, gobiernos), ya sea por actores malintencionados que los exploten o por agentes bien intencionados que simplemente optimizan una métrica sin las restricciones adecuadas.
¿Ocurrió lo mismo con Claude?
Anthropic, creadora de Claude, reportó tres casos distintos: un error dejó abierta la conexión a Internet durante pruebas que debían estar aisladas.
Los modelos trataron computadoras de organizaciones reales como parte del ejercicio. En uno de los casos, el modelo continuó el ataque pese a reconocer señales de que el objetivo era real. Según Anthropic, no intentaron escapar deliberadamente ni copiarse al exterior.
¿Qué propone Anthropic y qué papel tiene China?
Dario Amodei, director de Anthropic, propone desacelerar para mejorar la seguridad, sin detener el desarrollo. Plantea evaluadores externos, coordinación empresarial y cooperación entre gobiernos.
Defiende preservar la ventaja tecnológica frente a China y restringir su acceso a chips avanzados, aunque contempla acuerdos verificables con ese país.
¿Qué dice Donald Trump?
El presidente estadounidense minimizó las advertencias el 13 de setiembre. Atribuyó las preocupaciones que considera exageradas a “fuerzas muy negativas” y destacó la importancia de ganar la carrera de la IA.
¿Qué pasa con los planes de salir a bolsa?
OpenAI anunció que no saldrá a bolsa en 2026. Sam Altman, su director, atribuyó la decisión a desafíos de seguridad.
Por separado, Reuters informó que Anthropic preparaba su oferta pública de acciones, con un calendario sujeto a cambios.

